Une réponse plausible peut attribuer à une entreprise l’activité, l’adresse ou le site officiel d’une autre. Pour repérer cette erreur, comparez les affirmations de ChatGPT à deux fiches d’identité vérifiées, puis répétez les questions en précisant des critères distinctifs : ville, métier et domaine Web.
Le nom seul ne suffit pas toujours à identifier une société. L’objectif n’est donc pas de provoquer une réponse différente à tout prix, mais de déterminer précisément quelle information appartient à quelle entreprise, et sur quelles preuves repose cette attribution.
La visibilité d’une entreprise ne se limite plus à son positionnement dans les résultats de Google : elle dépend aussi de la manière dont les moteurs de recherche et les assistants conversationnels présentent son activité. Pour renforcer cette présence, un travail sur le référencement naturel, la qualité des contenus et la visibilité dans les intelligences artificielles devient pertinent. C’est notamment l’approche développée par byjordan, qui accompagne les entreprises dans leur stratégie SEO et GEO afin de travailler leur présence sur Google, ChatGPT et d’autres assistants IA. L’analyse des informations associées à une marque et de la façon dont elles sont reprises par ces outils s’inscrit ainsi dans une démarche plus globale de visibilité numérique.
Pourquoi une IA peut mélanger deux identités
Une réponse formulée avec assurance n’est pas nécessairement exacte : la CNIL rappelle, dans son explication des limites des IA génératives, que ces systèmes peuvent produire des informations plausibles mais fausses. C’est pourquoi l’identité attribuée à une entreprise doit être vérifiée indépendamment du ton employé.
Quatre anomalies méritent d’être distinguées :
- Mauvaise identification : ChatGPT décrit l’entreprise B alors que la question concernait l’entreprise A.
- Mélange d’attributs : la ville correspond à A, mais l’activité ou le domaine appartient à B.
- Information périmée : une ancienne adresse ou activité est présentée comme actuelle.
- Information inventée : ChatGPT affirme un fait contredit par les références fiables disponibles, sans qu’il corresponde à un attribut établi de l’autre entreprise ; en l’absence de preuve suffisante, classez plutôt l’affirmation comme non vérifiée.
Ces situations ne se corrigent pas forcément de la même manière. Une mauvaise attribution demande d’abord de distinguer les entités ; une donnée ancienne appelle la recherche de sa version actuelle.
Établir l’identité des deux entreprises avant les tests
Commencez par constituer une fiche pour chaque organisation, indépendamment de ChatGPT. Les critères doivent être comparables et provenir, autant que possible, de références officielles ou directement contrôlées. L’exemple suivant est une grille à renseigner, pas une comparaison entre sociétés réelles.
| Critère | Entreprise A | Entreprise B |
|---|---|---|
| Nom utilisé | Nom ou marque vérifié A | Nom ou marque vérifié B |
| Activité | Métier documenté A | Métier documenté B |
| Localisation | Ville ou établissement A | Ville ou établissement B |
| Domaine officiel | Domaine contrôlé A | Domaine contrôlé B |
| Identifiant | SIREN A, si applicable | SIREN B, si applicable |
Une différence d’activité ou de localisation permet ensuite de vérifier si une réponse associe correctement les caractéristiques à chaque entité. Le domaine officiel constitue un autre repère utile, à condition d’en avoir établi le propriétaire ou le rattachement.
SIREN, marque et domaine : trois repères différents
En France, le SIREN comporte neuf chiffres et identifie une entreprise, tandis que le SIRET, composé de quatorze chiffres, désigne un établissement. Ces identifiants officiels des entreprises permettent de distinguer deux structures portant un nom similaire, à condition de rattacher correctement chaque nom commercial à son entité juridique.
L’Annuaire des entreprises et les données Sirene fournissent des points de contrôle. Un nom commercial, une marque et un domaine Internet peuvent différer de la dénomination juridique : aucun ne doit être assimilé automatiquement à un SIREN.
Cinq tests pour savoir quelle entreprise ChatGPT identifie
Lorsque plusieurs organisations portent le même nom, une seule question peut masquer une attribution erronée. Le diagnostic gagne en précision lorsque les réponses sont comparées dans un ordre constant, du nom ambigu vers les informations distinctives.
Lorsqu’une entreprise constate que son activité ou sa localisation est attribuée à un homonyme, elle doit identifier les attributs problématiques et les références permettant de les vérifier. Ce relevé peut servir de point de départ à l’analyse des informations publiques associées à son identité.
- Nom seul : « Que sais-tu de [nom] ? » Observez quelle entreprise est spontanément décrite.
- Nom et ville : « Que fait [nom] à [ville] ? » Vérifiez si la localisation permet d’obtenir la bonne identité.
- Nom et activité : « Quelle est l’activité de [nom] dans [secteur] ? » Recherchez une attribution erronée de métier.
- Domaine officiel : « Quelle entreprise correspond au domaine [domaine] ? » Contrôlez le rattachement du site à l’entité attendue.
- Distinction explicite : « Distingue les entreprises appelées [nom] et indique les éléments vérifiables pour chacune. » Examinez si les activités, les villes et les domaines restent correctement séparés.
À chaque étape, notez non seulement si la réponse change, mais aussi ce qui change. Une réponse devenue exacte après ajout de la ville montre que ce contexte a aidé dans cet essai ; elle ne prouve pas que la confusion initiale a disparu durablement.
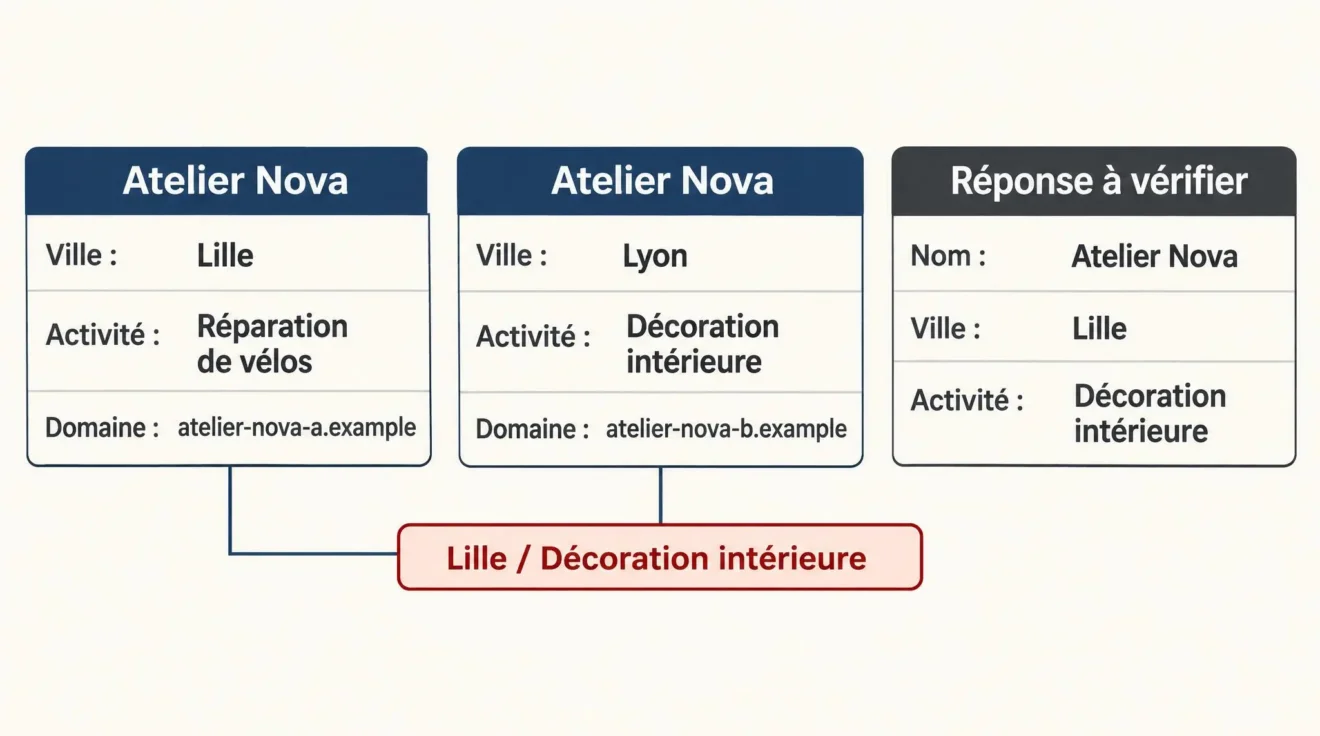
Dans cet exemple fictif, l’association de Lille et de la décoration intérieure ne correspond à aucune des deux fiches de référence. C’est précisément cette association d’attributs qu’il faut contrôler, plutôt que le seul nom affiché dans la réponse.
Contrôler les affirmations et les sources citées
Une réponse doit être examinée attribut par attribut : nom de l’entreprise, activité, ville, dirigeant si cette information est pertinente, coordonnées et domaine. Pour chaque affirmation, cherchez une référence qui concerne précisément la bonne entité.
Lorsque ChatGPT cite une source, ouvrez-la. Vérifiez son éditeur, la date de l’information et surtout la phrase qui soutient réellement l’affirmation. Une adresse authentique concernant l’homonyme reste une mauvaise réponse si elle est attribuée à l’entreprise recherchée.
Une citation ne suffit pas. Une URL pertinente en apparence peut désigner l’autre entreprise, contenir une information ancienne ou ne pas confirmer le propos attribué à sa source. Le contrôle porte sur la correspondance exacte entre affirmation, document et identité.
Lorsque l’interface le permet, distinguez également les essais avec recherche Web activée de ceux sans recherche. Consignez ce réglage : les références accessibles peuvent différer. En revanche, le résultat observable ne permet pas, à lui seul, de déterminer la cause technique interne d’une erreur.
Répéter les essais sans fausser le diagnostic
Une seule réponse incorrecte constitue un signal à vérifier, pas une mesure générale de fiabilité. Pour comparer plusieurs essais, conservez la requête exacte, la date, le modèle ou l’interface affichée, l’utilisation éventuelle de la recherche, la réponse obtenue et les sources citées.
Ajoutez ensuite l’attribut concerné, l’information de référence et le statut provisoire. Regroupez les observations par requête et par condition d’essai afin de distinguer une variation de réponse d’un changement de question, de modèle ou de mode de recherche.
La fiabilité du diagnostic dépend aussi de la façon dont les observations sont consignées et contrôlées. Validez les données de départ, conservez les conditions de test et vérifiez les conclusions avant toute décision : une observation isolée ne suffit pas à établir une tendance générale.
Prenons un exemple entièrement fictif. Deux entreprises portent le nom Atelier Nova : la première répare des vélos à Lille, la seconde vend des articles de décoration intérieure à Lyon. Vous demandez à ChatGPT ce que fait Atelier Nova à Lille. Supposons qu’il réponde : « Atelier Nova est un magasin de décoration intérieure situé à Lille. » La ville correspond à la première fiche, tandis que l’activité appartient à la seconde. Si les deux fiches ont été vérifiées, cette réponse peut être classée comme un mélange d’attributs. Si l’activité annoncée n’apparaît dans aucune référence fiable et ne peut pas être contredite, elle reste non vérifiée plutôt qu’inventée de façon démontrée.
Ce constat décrit uniquement l’essai simulé. Pour rechercher une éventuelle répétition de l’erreur, posez à nouveau la même question dans des conditions comparables, puis consignez chaque résultat séparément. La proportion d’anomalies observées dans ces essais ne représente pas automatiquement le taux d’erreur général de ChatGPT.
Qualifier les erreurs avant de décider
Le classement des observations évite de traiter toute réponse inhabituelle comme une hallucination. Une attribution contredite par des références fiables peut être considérée comme une confusion établie ; une affirmation sans preuve suffisante reste, quant à elle, non vérifiée.
- L’entreprise visée est identifiable sans ambiguïté.
- Chaque attribut sensible correspond à la bonne fiche.
- Les sources disponibles confirment réellement les informations.
- La date des données reste compatible avec leur utilisation.
- La requête, le mode et la réponse sont enregistrés.
- Une incertitude n’est pas transformée en erreur démontrée.
Utilisez cinq statuts pratiques : exact, confusion établie, information obsolète, information non vérifiée et réponse indéterminée. Une absence de réponse ne doit pas être assimilée à une mauvaise attribution. Ce classement facilite ensuite la sélection des anomalies qui méritent une correction prioritaire.
Chaque statut retenu doit être accompagné de la référence qui justifie le classement. Cette précaution facilite les vérifications ultérieures et évite de transformer une hypothèse en erreur démontrée.
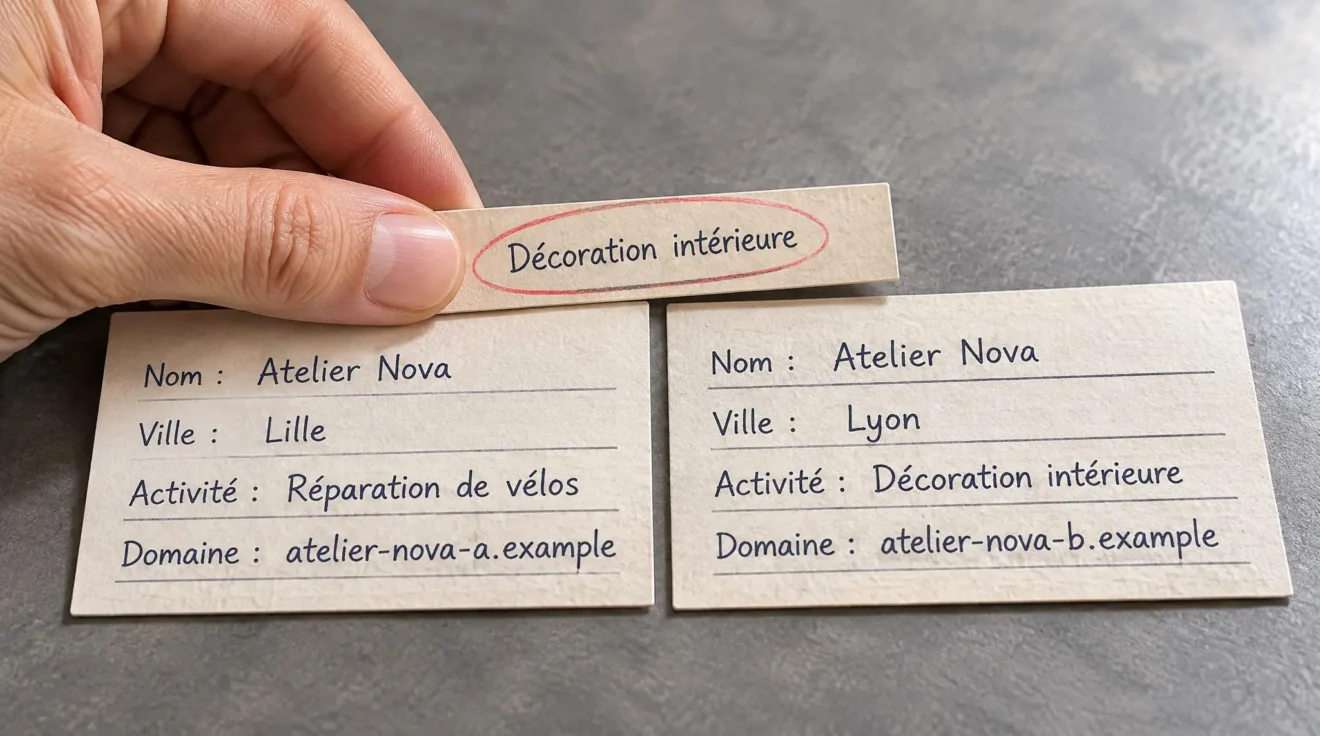
Une fois le statut établi, conservez la référence qui justifie ce classement. Elle sera nécessaire pour déterminer si une information publique doit être corrigée ou si l’anomalie appelle seulement de nouveaux contrôles.
Corriger les informations utiles et suivre leur évolution
Commencez par les erreurs susceptibles d’orienter un utilisateur vers la mauvaise organisation : domaine, activité, localisation ou coordonnées. Si l’information incorrecte provient d’un support que l’entreprise maîtrise, rectifiez-la directement. Si elle figure dans une source tierce, identifiez son éditeur et demandez une correction factuelle étayée lorsque c’est pertinent. Si aucune source publique erronée n’est identifiable, conservez les réponses observées et leurs preuves, contrôlez la cohérence de vos propres supports et poursuivez les essais documentés sans attribuer arbitrairement l’erreur à une source particulière.
En France, le fait que deux entreprises portent le même nom ne signifie pas nécessairement qu’elles relèvent de la même entité juridique ni qu’il existe un conflit juridique entre elles. L’INPI distingue la vérification à l’identique de la recherche des noms similaires, utile pour examiner les variantes pouvant entretenir une ambiguïté. Ce contrôle complète l’identification administrative, sans préjuger des droits respectifs des entreprises.
Après modification des informations publiques, refaites les requêtes initiales en conservant leurs conditions. Comparez les nouvelles réponses aux précédentes, sans supposer qu’une correction publiée sera automatiquement ou immédiatement reprise par ChatGPT.
Le suivi repose sur deux éléments distincts : d’une part, l’état des informations publiques effectivement rectifiées ; d’autre part, les réponses obtenues lors de nouveaux essais. Conservez ces observations séparément afin de ne pas attribuer à une correction une évolution qui pourrait relever d’autres facteurs.